 PDF Download
 PubReader
 Export Citation
 Email the Author
 Share Facebook
 Share Twitter
 Cited by 0 Article
 Metrics (View:38)

1. 서론
본 연구의 목적은 한국어 단모음 /ㅓ/가 가진 음성적 원순성의 양상을 음성학적으로 검증하여 한국어 교수 학습을 위한 /ㅓ/의 음성적 특성을 밝히는 데 있다.
현대 한국어의 단모음 체계에서 /ㅓ/는 후설 평순 모음으로 분류된다. /ㅓ/의 IPA는 연구자에 따라 [ʌ], [ə], [ɤ] 등으로 보는데, 이들은 개구도의 정도 차이가 있을 뿐 모두 평순후설중모음의 범주에 해당한다(Heo & Kim, 2017;1Kang, 2017; Kwon, 2017; Maddieson, 1984; Oh, 2015; Shin et al., 2015; Yang, 2018).2 그럼에도 /ㅓ/의 음성적 원순성이 있음은 여러 선행 연구에서 지적되어 왔다. Heo & Kim(2017)은 /ㅓ/는 영어의 /ɔ/보다 작지만 약간의 원순성을 갖는다고 했는데, 이는 개구도가 커지면서 입술이 둥글어져 약간의 원순성을 갖는다(Stevens, 1972)는 설명으로 뒷받침된다. 즉 /ㅓ/의 음성적 실현에 원순성이 존재하는 것은 사실이지만 이는 /ㅗ/, /ㅜ/와 같이 음운론적인 [±원순성]의 자질 대립과는 다르며, 모음의 음향적 안정성을 높이기 위한 조음의 미세조정에서 비롯된 음성적 변이음이므로 음운론적으로 /ㅓ/는 평순 모음으로 본 것이다. 같은 현상을 Kwon(2017:122-123)은 /ㅓ/와 /ㅗ/를 비교하여 /ㅓ/가 /ㅗ/에 비해 더 벌어지면서 입술이 양 옆으로 퍼져 앞으로 돌출하지 않는다고 설명했다. 이는 원순 모음 /ㅗ/를 기준으로 /ㅓ/의 음가를 설명한 것으로/ㅓ/가 평순 모음임에 근거한다.
이러한 음운론적 해석은 한국어 교수 학습 현장에도 그대로 적용된다. 문제는 평순 모음 /ㅓ/의 지각, 산출에서 학습자의 모어를 막론하고 원순 모음 /ㅗ/와의 변별 오류가 다수 발생한다는 것이다. 의사소통 중심 한국어 교수 학습에서 /ㅓ/가 평순 모음임을 명시하지는 않는다. 그러나 교사들은 자신들이 학습한 한국어 모음 체계에 따라 /ㅓ/를 평순 모음으로 전제하여 음성적 원순성의 가능성을 배제하고 발음을 지도한다. 이러한 관점은 학습자가 /ㅓ/의 음가를 습득, 적용하는 과정에서 혼란이 발생하는 원인으로 작용할 수 있으며, Heo & Kim(2017)의 /ㅓ/의 원순성을 인정하는 관점에 배치된다. 이로 인해 발생하는 오류는 단지 /ㅓ/에 대응하는 단모음이 학습자 모국어에 없다거나 학습자가 느끼는 /ㅓ/의 음가가 불분명하다는 것만으로 설명하기 어려우며, /ㅓ/를 평순 모음으로 제시하는 음운론적 분류와 음성적 실현 간 괴리가 존재할 가능성을 시사한다. 따라서 학습자의 단모음 습득 오류를 줄이기 위해서는 /ㅓ/에 잠재하는 음성적 원순성의 양상을 확인하여 한국어 교수 학습을 위한 단모음 체계에서 /ㅓ/를 기술하는 방법을 논의할 필요가 있다.
‘모음의 원순성’을 Lee(2017b:317)는 평순 모음과 대립하는 부류인 원순 모음을 발음하는 방법으로서 ‘입술 모양에 따라 단모음을 분류할 때 입술을 동그랗게 오므려 발음하는 특징’으로 정의한다. 이에 대해 Shin(2014:93)은 ‘조음할 때 입술을 모아서 앞으로 돌출’하며, 이로 인해 성도의 길이가 달라지면서 산출되는 모음의 음가가 달라진다고 설명한다. 즉 본 연구에서 음성학적 의미에서의 ‘원순성’은 ‘모음을 발음할 때 입술을 동그랗게 만들어 앞으로 돌출하게 만드는 조음 방법’이라고 할 수 있다. 이에 모음의 원순성을 판단하는 음향음성학적 방법은 F3(Cho, 2022; Huh, 2019; Park & Kim, 2025) 또는 F3Bark-F2Bark 간 거리의 측정, 스펙트럼의 기울기나 에너지를 측정하는 방법 등이 있다. 본 연구에서는 이 중 F3Bark와 F3Bark-F2Bark, 그리고 한국어를 학습한 적 없는 프랑스인 모어 화자의 모국어와의 청지각적 대조를 통해 /ㅓ/의 음성적 원순성 여부와 정도를 논의한다.
2. 연구 설계
본 연구는 /ㅓ/의 원순성을 음성적으로 판단하기 위해 한국인 모국어 화자가 산출한 /ㅓ/ 및 각 단모음의 F3Bark-F2Bark와 F3Bark, F2Bark를 측정했다. 그리고 프랑스어를 모국어로 사용하는 외국인 화자의 청지각을 통한 지각적 유사성 판단 실험을 수행했다.
F3와 F2 모두 원순성에 의해 Formant 주파수가 하강한다(Shin, 2014). 이는 입술의 돌출로 인해 성도의 길이가 늘어나면서 특히 F3 이상의 공명 주파수를 낮추는 음향적 특성으로 관찰된다(Fant, 1960). 다만 F3에 영향을 주는 요인은 원순성에 의한 성도 길이나 입술의 돌출뿐만 아니라 후두의 위치, 혀의 조음 등의 영향도 있다. 이에 혀의 전후설성을 반영하는 F2와의 거리를 측정하는 F3-F2는 원순성과 관련된 차이를 탐색하는 상대적 지표로 적절하다. 그럼에도 F3-F2는 두 지표의 파생 지표로서 개별 값의 영향이나 혀의 전후 위치, 화자별 성도의 길이나 공명의 차이, 모음 범주 자체의 차이 등을 완전히 배제하지는 않는다. 따라서 주파수는 임계대역률을 반영한 Bark로 변환하여 F2Bark와 F3Bark의 개별 추정평균을 함께 해석함으로써 F3Bark–F2Bark의 값을 주도하는 각 Formant의 추정주변평균과 모음 간 검정 결과를 함께 제시한다.
또한 음향 분석을 통해 /ㅓ/의 음성적 원순성 여부 또는 정도가 확인되더라도 실제로 원순성 범주가 명확한 언어를 모어로 사용하는 화자가 이를 지각하는지 확인할 필요가 있다. 이를 위해 Flege(1995)의 음성 학습 모델에 근거하여 원순성의 지각적 강도를 관찰하기 위해 모국어에 원순 모음 범주가 명확한 프랑스인 모어 화자를 대상으로 청지각 실험을 수행했다. 이를 통해 /ㅓ/의 산출 및 교차언어 지각에서 원순성과 관련될 수 있는 음향적, 지각적 단서가 나타나는지 다층적으로 탐색하고자 했다.
/ㅓ/와 한국어 단모음의 음향음성학적 분석은 한국인 참여자를 대상으로 단어를 녹음한 후, 음성분석 프로그램을 사용하여 시료 분석과 통계화 과정을 거쳤다.
음성 녹음에 참여한 집단은 한국인 모국어 화자 30명이다. 이들은 20-30대(평균 28.5세, σ=4.8)의 서울, 경기권 출신으로 서울, 경기, 인천에 거주하는 여성이다. 이들은 A2–B1 수준의 영어를 구사할 수 있으나 일상 생활에서 영어를 거의 사용하지 않으며, 모국어나 외국어 학습에서 발음 교정을 받은 경험이 없었다.
녹음 단어는 한국어의 7개 단모음에 ‘-마마’를 결합한 3음절의 무의미 단어3로, 참여자들은 평소 발화하는 습관대로 해당 단모음을 3번씩 낭독했다. 녹음은 소음이 통제된 강의실에서 Zoom 사의 H1n을 사용하여 44,100 Hz 양자화 16 bit, mono로 이루어졌고 .wav 파일로 저장했다. 이렇게 수집한 총 630개의 음성 자료(7개 단모음×3회 낭독×30명)는 Praat 7.0을 사용하여 텍스트그리드로 라벨링한 후, Formant 값의 변동이 적은 모음 지속시간의 중간 50%를 안정 구간으로 보아 그 안에서 프로그램 내 알고리즘을 사용하여 단모음 내 Formant를 추출했다. 각 Formant 수치는 Hz를 청지각의 임계 대역을 반영하는 심리 음향적 척도인 Bark로 변환하는 Zwicker 수식 (1)을 적용했다.
추출된 Formant는 엑셀로 정리하여 R의 dplyr 패키지를 사용하여 통계를 구했다. 이때 화자 간 반복측정의 비독립성을 고려하여 각 Formant 및 Bark 값을 종속변수로, 모음을 고정효과, 화자를 임의효과로 포함한 선형혼합모형(수식 (2))을 적용했다.
모음의 전체 효과는 F2Bark와 F3Bark 모두 유의했다(p<0.001). 모음별 평균은 모형 기반 추정주변평균으로 산출하였고 표준편차는 화자 임의효과를 제거한 값에서 계산했다. 화자 수준 변이[ICC(intraclass correlation coefficient), 수식 (3)]와 임의효과 표준편차는 표 1과 같다.
| 지표 |
F1 (Hz) |
F2 (Hz) |
F3 (Hz) |
F1Bark | F2Bark | F3Bark |
F3Bark -F2Bark |
|---|---|---|---|---|---|---|---|
| Residual_sd | 85.9 | 201.7 | 267.4 | 0.7 | 0.9 | 0.6 | 1.1 |
| Subject_sd | 25.1 | 66.0 | 195.0 | 0.2 | 9.3 | 0.4 | 0.6 |
| ICC(%) | 7.8 | 9.7 | 34.7 | 7.5 | 50 | 30.8 | 23.0 |
각 단모음의 원순성 비교는 핵심 지표인 F3Bark-F2Bark의 평균값이 높을수록, 보조 지표인 F3Bark, F2Bark의 평균값이 낮을수록 원순성이 강한 것으로 해석했다. 이후 모음 간 차이를 확인하기 위해 Kenward-Roger 자유도 보정과 Tukey 다중비교보정을 적용한 추정주변평균 간 사후검정을 실시하여 비교했다.
외국인 학습자의 /ㅓ/의 원순성 지각 양상을 확인하기 위해 한국어 단모음과 학습자 모국어 단모음을 비교하는 청지각 대면 실험을 수행했다. 참여자는 파리 및 Île-de France 지역 출신의 프랑스인 20대 초반(평균 22세, σ=1.5) 여성 10명으로 한국 거주 기간은 2개월이나 한국어를 학습한 경험이 없다.
참여자들은 실험지에 자신이 각 문항에서 들은 음성 자극과 가장 비슷하다고 생각하는 프랑스어 모음을 상단의 표에서 1–2개를 골라 쓰고, 자극과 자신이 선택한 각 프랑스어 단모음이 얼마나 비슷하다고 생각하는지 8단 Likert 척도에 표시했다. 음성 자극과 선택한 단모음이 비슷하다고 생각할수록 7에 가깝게, 다르다고 생각할수록 0에 가깝게 표시했다. 프랑스어 단모음은 해당 단모음을 목표 음가로 산출되는 단어와 함께 제시하여 음가와 표기가 1:1로 대응하도록 했다. 단모음의 제시 순서는 개구도와 전후설성, 원순성 순으로 실험지에 제시된 프랑스어 단모음과 예시 단어, 문항별 Likert 척도 및 응답 예시는 그림 1과 같다.
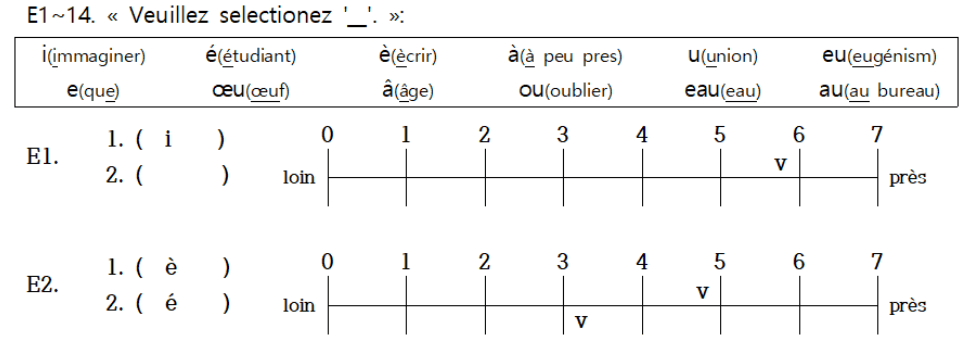
총 문항은 7개 한국어 단모음을 포함한 21개로, 이중 /ㅓ/에 해당하는 문항은 3개이다. 문항에 제시된 단모음 자극은 각각 서울 출신의 30대 여성 2명, 남성 1명으로, 이중 여성 2명의 시료는 2.1의 녹음 참여자가 산출한 음성 중 예비 실험에 참여한 10명의 /ㅓ/의 F1, F2 평균에 가장 근접한 수치를 보인 토큰과 전설화 경향이 있는 토큰을 추출하여 사용했다. 남성 1인의 목소리는 별도로 녹음하여 사용했는데, 이는 청자가 단일 성별의 음향적 특성에만 의존하는 것을 방지하고 화자 다양성을 확보하기 위함이다. 다만 성별이 결과에 영향을 줄 가능성에 대해 성별을 고정효과로 포함한 모형과 포함하지 않은 모형을 비교한 결과 유의한 적합도 개선을 보이지 않아[χ2(1)=0.009, p=0.924] 화자의 성별에 따른 지각 평정 차이를 확인하지 못했다. 음성 자극 /ㅓ/의 각 Formant 값과 타원 내 위치는 표 2와 같다.
| 자극 | 성별 | F1(Hz) | F2(Hz) | 타원 내 위치 | 비고 |
|---|---|---|---|---|---|
| 1 | 여 | 690.6 | 1,0510.5 |
타원 상단 (고개구도) |
명료화 |
| 2 | 남 | 538.8 | 818.8 |
타원 우측 (후방화) |
원순화 강화 |
| 3 | 여 | 675.1 | 1,105.7 |
타원 좌측 (전방화) |
전설화 경향 |
자극의 대표성을 검증하기 위해 그림 2의 /ㅓ/에 해당하는 신뢰타원과 비교한 결과, 각각 개구도 상단, 전후설의 좌·우측, 낮은 F2 영역에 분포했다. 각 개별 자극의 분포는 /ㅓ/의 음운론적 범주를 대표하면서 음성적 맥락의 다양한 변이를 포괄하도록 구성하여 청지각 응답이 /ㅓ/의 평균적 음가뿐만 아니라 실제 발화에서 나타나는 다양한 조음 실현에 대한 지각 양상을 반영하도록 했다.
10명의 참여자가 각각 3개의 /ㅓ/ 자극에 응답하였으므로 기본 응답 단위는 30개이다. 그러나 11개 문항에서 각각 2개의 응답이 확인되어 수집된 자극 /ㅓ/의 응답 수는 41개이며, 1인당 응답 수의 평균은 1.37개이다.
우선 참여자가 느끼는 /ㅓ/-프랑스어 단모음 간 대응 양상을 확인하기 위해 문항별로 수합된 프랑스어 단모음의 IPA를 근거로 조음 자질을 확인했다. 지각 평정은 0–7 범위의 순서형 Likert 척도로 수집되었으며, 일부 응답에서는 0.5 단위의 중간값이 사용되었다. 응답 간 간격이 동일하다고 가정하지 않기 위해 누적연결 혼합모형[CLMM(cumulative link mixed model), 수식 (4)]을 사용하여 자극음에 대한 응답에 대해 조건별 모형 기반 예상 평정을 산출했다. 이는 동일한 참여자가 여러 문항에 반복 응답한 비독립성을 반영하기 위한 것으로, 참여자와 문항을 임의효과로, 모음 효과는 고정효과로 포함했다.
각 자극모음에 대한 선택모음 조건에 대해 모형에서 예측된 Likert 범주별 확률을 산출하고, 각 범주값과 예측확률의 곱을 합산하여 모형 기반 예상 평정을 계산했다. 자극음에 대한 선택 모음 조건 간 추정값의 pairwise comparison에는 Tukey 다중비교 보정을 적용했고, 그 결과 제시된 선택 모음 조건 간 비교에서 통계적으로 유의한 차이는 관찰되지 않았다(pTukey>0.05)6.
그리고 선택 빈도와 각 응답의 Likert 평정 강도를 함께 반영한 Likert 가중 선택 비율은 수식 (5)를 사용했다.
I(selectedi=c)는 해당 응답이 선택모음 C를 선택한 경우 1, 그렇지 않을 때 0인 지시함수이고, ri는 해당 응답의 Likert 재코딩 평정값이다. 분모는 같은 자극모음에 대한 모든 응답의 평정값에 대한 합계(total rating weight)로, /ㅓ/의 총 41개 응답에 대한 평정 가중치 합계는 134였다.
단순 선택 비율은 빈도만 반영하므로 보조적 기술통계로 제시하고, Likert 평정값을 반영한 Likert 가중 선택 비율을 지각적 선택 강도의 지표로 제시한다. 다만 이는 원자료에서 계산한 가중 요약값이며, 별도의 확률모형에서 직접 추정된 선택확률은 아니다. 통계적 유의성 검정은 가중 선택 비율 자체가 아닌 원래의 순서형 Likert 응답을 종속변수로 한 CLMM에서 수행하고 선택 모음 조건 간 Tukey 보정 pairwise comparison을 실시했다. 이를 통해 얻은 결과는 Flege(1995)의 음성 학습 모델(speech learning model, SLM)에 근거하여 음성 범주의 형성과 지각 양상을 해석했다.
이를 근거로 학습자가 /ㅓ/를 접했을 때의 원순성 지각 강도와 원순성의 실제 음성적 수치, 음운적 해석 간 차이를 제시했다. 나아가 한국어 교수 학습에서 /ㅓ/가 평순 모음으로 기술되는 것에 대한 음성적 엄밀성을 논의했다.
3. 연구 결과
서울, 경기 지역 20–30대 여성 화자가 산출한 한국어 단모음의 음성 공간은 그림 2와 같이 신뢰타원(95% CI)으로 표시된다.
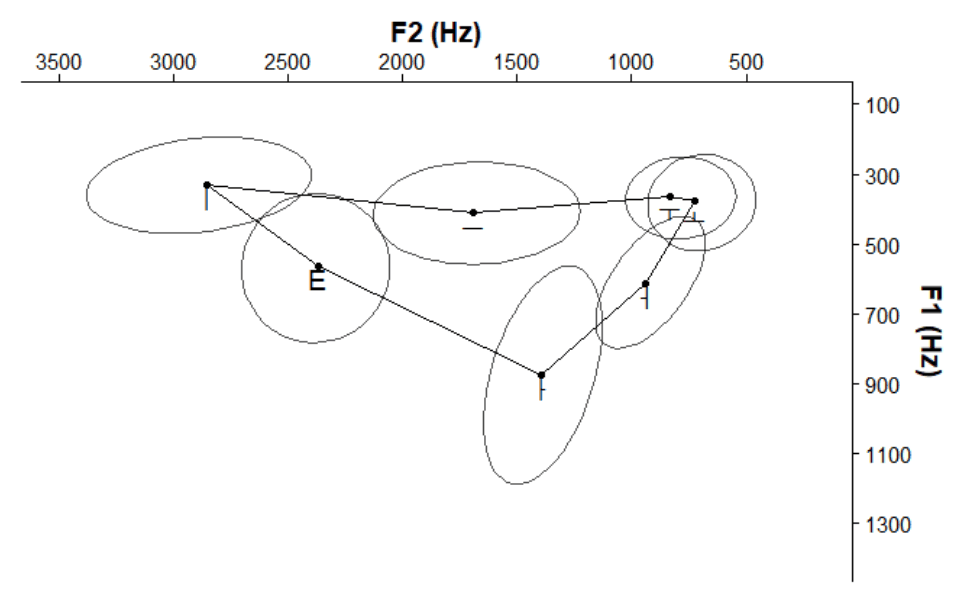
본 연구의 단모음 분포에서는 선행 연구에서 보고된 /ㅡ/, /ㅜ/의 전방화와 /ㅗ/의 고모음화 및 어두 /ㅓ/의 개구도 상승 등이 나타나며, /ㅗ/의 F2가 /ㅣ/의 대척점에 위치한다(Ha & Hwang, 2024; Ha & Oh, 2017; Jang et al., 2015; Lee et al., 2017; Shin, 2018; Yang, 2018). 이는 한국어의 음성적 모서리 모음이 /ㅣ/, /ㅏ/, /ㅜ/가 아닌 /ㅣ/, /ㅏ/, /ㅗ/임(Yang, 2018)을 뒷받침한다.
/ㅗ/와 /ㅜ/가 개구도의 고저가 아니라 전후설성으로 대립한다(Ha & Oh, 2017; Jung & Lee, 2017; Kang & Kong, 2016; Yoon & Kim, 2015)는 선행 연구의 결과에 따라 후설모음 간 F2 차이의 변별력이 통계상 유의한지 확인하기 위해 Tukey 보정 추정주변평균 간 사후비교를 수행했다. 그 결과 모든 비교쌍의 변별력은 유의하거나 매우 유의했으며(p<0.01), /ㅗ/는 /ㅜ/를 포함한 다른 단모음 간 유의도가 가장 높아(p<0.001) 후설 모음 체계에서 전후설 대비를 주도하는 모음임을 확인했다. 이 역시 한국어 원순모음인 모서리 모음은 /ㅗ/이라는 Yang(2018:454)을 지지하는 결과이다. 이에 본 연구에서는 /ㅓ/의 원순성을 검증하기 위해 인접 평순모음 /ㅡ/, /ㅜ/와 함께 모서리모음 /ㅣ/, /ㅏ/, /ㅗ/의 수치를 비교하여 논의한다.
각 한국어 단모음의 F2Bark, F3Bark와 F3Bark-F2Bark의 추정 주변평균과 화자별 평균의 표준편차, 95% CI는 표 3과 같다.
각 단모음의 수치는 /ㅗ/>/ㅜ/>/ㅓ/>/ㅏ/>/ㅡ/>/E/>/ㅣ/ 순으로 배열된다. Tukey 보정에 의한 모음 간 사후 비교 결과, 전체 21개 비교 중 20개 쌍에서 수준의 유의한 통계적 차이가 나타났으며(p<.005) 유의하지 않은 차이가 나타난 비교쌍은 /ㅣ/-/E/(p=0.88)이다. 같은 원순모음임에도 /ㅗ/와 /ㅜ/의 음성적 원순성 정도는 유의한 차이를 보이는데, 이는 /ㅜ/가 원순성이 약해져서라기보다 원순성을 유지한 상태에서 그림 2와 같이 /ㅜ/가 /ㅗ/보다 전방화되어 F2가 상대적으로 높아졌기 때문에 F3Bark-F2Bark의 값이 낮아진 것으로 보인다. 다만 본 연구의 자료만으로는 전방화와 원순성의 관계를 분리하여 검증할 수는 없다.
/ㅓ/는 /ㅜ/와 유의한 추정평균 차이를 보였다(p=0.003). 따라서 이 지표에서 두 모음을 동일한 평균값을 갖는 범주로 해석할 수는 없다. 다만 추정평균 차이의 절대값은 원순 모음인 /ㅜ/와는 0.6 Bark, /ㅗ/와는 1.4 Bark로 이는 평순 모음인 /ㅡ/와 3.4 Bark, /ㅏ/와 2.2 Bark보다는 작아 다른 후설 모음보다 /ㅜ/에 상대적으로 더 가까운 위치를 보였다. 다만 이를 원순 모음에 둘 다 근접한다고 보는 것은 적절하지 않으며, F3Bark–F2Bark 차원에서 /ㅜ/에 상대적으로 더 가깝다고 한정하는 것이 적절하다.
즉 F3Bark-F2Bark 단독으로는 /ㅓ/가 원순 모음에 해당하는 음향적 특성을 보인다고 판단할 충분한 근거가 확보되지는 않았다. 다만 F3Bark-F2Bark는 F2의 전후설성과 F3의 공명 특성이 함께 반영되어 있기 때문에 이 결과만으로 /ㅓ/의 원순성이 없다고 단정하기는 어려우므로 F2Bark와 F3Bark를 함께 검토한다.
F2Bark의 평균을 큰 값에서 작은 값으로 배열하면 /ㅣ/-/E/-/ㅡ/-/ㅏ/-/ㅓ/-/ㅜ/-/ㅗ/ 순으로, Tukey 보정 사후검정 결과 모든 모음 쌍에서 유의한 차이를 보였다(p<0.005). 이는 F3Bark–F2Bark의 배열과는 역순으로, /ㅗ/와 /ㅜ/는 후설 원순 모음으로서 가장 낮은 F2Bark 값을 보였고 특히 /ㅗ/는 가장 낮은 값을 보였다. 그리고 /ㅓ/는 평순 모음인 /ㅏ/나 /ㅣ/보다는 낮은 수준의 F2Bark 값을 보인다. 이러한 결과는 원순 모음으로 분류되는 모음에서 F2Bark의 하강이 나타난다는 경항과 일치하여 F3Bark–F2Bark에 기반한 원순성 순위를 부분적으로 지지한다. 그러나 F2는 원순성뿐만 아니라 혀의 전후 위치를 반영하는 음향 지표이므로 F2Bark의 하강을 전적으로 원순성에 의한 효과로 해석할 수는 없다. 또한 F3Bark–F2Bark가 F3Bark과 F2Bark의 차이로 계산된 지표라는 점에서 F2Bark의 결과는 보조적으로 해석되어야 할 것이다.
F3의 원자료 분포와 LMM(linear mixed model) 추정평균 및 95% CI는 그림 3과 같다.
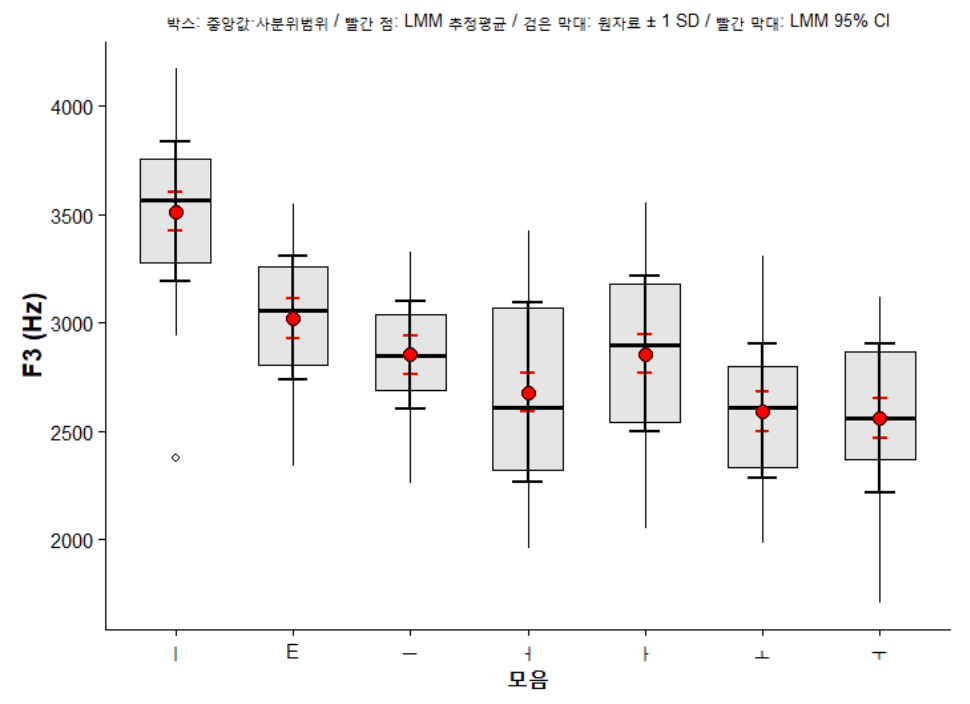
F3Bark의 혼합효과모형 기반 추정평균은 /ㅣ/>/E/>/ㅡ/>/ㅏ/>/ㅓ/>/ㅗ/>/ㅜ/ 순이다. F3Bark에 의한 모음 간 유의성 쌍은 Tukey 보정 사후비교에서 /ㅡ/-/ㅏ/(p=1), /ㅗ/-/ㅜ/(p=0.943), /ㅓ/-/ㅗ/(p=0.485), /ㅓ/-/ㅜ/(p=0.053)으로 p<0.05 수준에서 유의하지 않고 나머지 쌍은 모두 유의한 차이가 있는 것으로 나타났다(p<0.005).
F3Bark의 혼합효과모형 기반 추정평균에서 /ㅓ/는 /ㅗ/와는 0.1 Bark, /ㅜ/와는 0.2 Bark 차이를 보여 후설 평순 모음으로 분류되는 /ㅡ/나 /ㅏ/(각각 0.4 Bark)보다 작은 차이를 보였다. 따라서 F3Bark에서 /ㅓ/는 평순 모음인 /ㅡ/나 /ㅏ/보다 원순 모음인 /ㅗ/와 /ㅜ/에 상대적으로 가까운 위치를 보였고, 그중 /ㅗ/와의 평균 차이가 가장 작았다.
이러한 결과가 /ㅓ/와 원순 모음의 원순성이 통계적으로 동등하거나 동일한 음향 범주임을 직접 의미하는 것은 아니다. 또한 F3는 원순성의 직접적인 조음 지표가 아니며, 성도 길이와 공명 구조에도 영향을 받는다. 따라서 F3Bark의 분석 결과는 /ㅓ/를 평순 모음보다 원순 모음에 근접하게 나타나지만 이를 근거로는 /ㅓ/에 원순성 관련 음향 단서가 뚜렷하다고 단정할 수는 없으며, 원순성과 관련된 음향 특성의 가능성을 시사하는 제한적 관찰로는 해석할 수 있다.
세 지표 모두 원순성에 관한 정보를 일부 제공하지만, 원순성 자체를 직접 지시하지는 않는다는 점에서 한계를 갖는다. 특히 F3Bark-F2Bark는 F2Bark와 F3Bark로 구성된 파생 지표이므로 F2 및 F3의 결과와 독립적으로 검토할 수 없으며, 두 구성 요소의 전후설성, 성도 공명과 관련된 효과가 함께 반영될 수 있다. 또한 각 지표 간 모음 순위나 유의도, 추정평균이 일치하지는 않는다.
F3Bark-F2Bark에서 /ㅓ/는 원순 모음 /ㅜ/와 유의한 평균 차이를 보였고(평균차 0.6 Bark, Tukey 조정 p=.0032), /ㅗ/와의 평균차는 1.4 Bark였다. 여기서 /ㅓ/의 음향적 위치는 두 원순 모음과 동일하지 않지만 /ㅓ/-/ㅜ/의 평균차는 평순 모음인 /ㅡ/나 /ㅏ/보다는 작아 /ㅜ/에 상대적으로 더 가까운 위치를 보였다.
F3Bark에서는 /ㅓ/가 /ㅗ/와는 0.1 Bark, /ㅜ/와는 0.2 Bark 차이를 보여 /ㅡ/나 /ㅏ/의 차이보다는 작은 평균차를 보였으며, /ㅓ/-/ㅗ/(p=.485) 및 /ㅓ/-/ㅜ/(p=.053) 대비에서는 Tukey 보정 후 유의한 평균차의 증거가 나타나지 않았다.
종합하면, /ㅓ/는 F3Bark에서는 원순 모음에 상대적으로 가까운 위치를 보였으나 F3Bark-F2Bark에서는 원순 모음과 유의하게 구별되었다. 따라서 본 자료를 통해 /ㅓ/가 전형적인 원순 모음과 같은 음향적 특성을 지닌다고 볼 수는 없다. 다만 /ㅓ/의 음향적 특성은 평순 모음과도 동일하지는 않으며, 원순 모음과 상대적으로 근접한 양상을 보인다는 점에서 선행 연구에서 제기된 ‘약간의 음성적 원순성’(Heo & Kim, 2017; Stevens, 1972)을 제한적으로 지지한다.
프랑스인 모어 화자가 지각한 단모음 /ㅓ/ 자극에 대응하는 프랑스어 단모음은 전체 12개 중 6개로, 대응 정도는 표 4와 같다.7
/ㅓ/에 대한 청지각적 프랑스어 단모음 대응은 후설 원순 모음인 /eau/([o])와 /au/([ɔ])에 응답이 집중되었다. 다만 응답 비율과 상관없이 ‘자극음과 선택한 모국어 음운이 얼마나 가깝다고 생각하는지’에 대한 Likert 척도 기반의 모형 기반 예상 평정은 1개의 응답만 나타난 /ou/를 제외하고 모두 2.25–2.68점대의 낮은 수준이다. 이는 선택 비율과 무관하게 자극음인 /ㅓ/와 모국어의 /eau/, /au/의 지각적 범주를 상대적으로 가깝게 배정했지만 모음 간 지각적 유사성도 높다고 판단한 것은 아님을 시사한다.
이러한 지각 결과를 3.1의 음향 분석 결과와 비교하기 위해 /ㅓ/와 /ㅗ/ 자극에 대한 /eau/와 /au/의 선택 대응 정도를 표 5와 같이 비교했다(/ㅗ/의 total rating weight=225).
| 대응 지표 | /ㅓ/[ʌ] | /ㅗ/[o] | ||
|---|---|---|---|---|
| /eau/[o] | /au/[ɔ] | /au/[ɔ] | /eau/[o] | |
| 응답 수 | 19/41 | 15/41 | 23/41 | 18/41 |
| 선택 비율 | 46.3 | 36.6 | 56.1 | 43.9 |
| 모형 기반 예상 평정 | 2.68 | 2.33 | 5.76 | 5.41 |
| 가중 선택 비율(%) | 45.9 | 36.2 | 58.4 | 46.1 |
/ㅓ/와 /ㅗ/ 자극에 대한 응답을 /eau/와 /au/로 한정할 때, /ㅓ/ 자극에서 /eau/와 /au/에서 모두 높은 집중도를 보였으나, 이는 원순 모음 /ㅗ/에 비하면 모형 기반 예상 평정에서 각각 3.08점 낮으며 가중 선택 비율에서도 낮은 수치를 보인다. 즉 /eau/와 /au/ 모두 /ㅓ/로 범주화될 수 있지만 지각적 적합도는 /ㅗ/에서 훨씬 높았다.
이 결과는 3.1과도 부분적으로 연결된다. /ㅗ/는 F3Bark-F2Bark에서 F2Bark가 가장 낮아 본 연구에서 사용한 원순성 관련 음향 지표에서 가장 뚜렷한 원순모음적 특성을 보였다. 반면 /ㅓ/는 F3Bark-F2Bark에서 /ㅜ/와, F3Bark에서는 /ㅗ/, /ㅜ/와 유사한 양상을 보였지만 F2Bark에서는 두 원순 모음과 유의미하게 구별되었다. 따라서 /ㅓ/는 전형적인 원순 모음이라기보다는 일부 원순성 음향 단서를 보이는 중간적 모음으로 해석하는 것이 적절하다.
한국어의 단모음 체계에서 /ㅓ/는 평순 모음으로 분류된다. 그러나 음향적 분석 결과 /ㅓ/는 전형적인 원순 모음은 아니지만 일부 지표에서 평순 모음보다 원순 모음에 가까운 양상을 보였다. 나아가 이러한 음성적 수준의 원순성이 외국인 모어 화자의 청지각에도 영향을 미칠 수 있음이 확인되었다. 특히 후설 평순 중모음의 음운 범주가 없는 외국인 모어 화자는 처음 듣는 음성 자극을 자신의 모국어 음성 범주에 따라 해석하는 과정에서 /ㅓ/를 상대적으로 자주 원순 모음에 가깝게 지각한다. 본 연구에서 /ㅓ/와 /ㅗ/의 직접적 변별 또는 대치 오류를 측정한 것은 아니나 일부 동일한 프랑스어 모음 범주로 연결될 수 있음이 확인되었다. 이는 두 모음의 지각적 차이가 단지 조음 위치의 차이뿐만 아니라 관련 음향 단서의 차이와도 관련될 수 있다는 가능성을 제기한다.
한국어 교육의 음운 체계 기술에서 /ㅓ/를 평순 모음으로 분류하는 것은 음운론적으로 타당하다. 다만 /ㅓ/가 실제 발화에서 항상 전형적인 평순 모음의 음향적 특성만을 보이는 것은 아니며, 화자와 발화 조건에 따라 일부 원순 모음과 유사한 음향적 단서를 가지기도 한다. 특히 한국어 교육에서 모음을 제시할 때는 본 연구에서 사용된 시료와 같이 /ㅓ/의 원순 모음의 음향적 단서가 강조될 수 있는 어두 또는 단일 모음 제시 환경(Shin, 2018)이 자주 나타난다. 그러나 이 결과에서 나타나는 /ㅓ/의 음향적 실현이 모든 발화 환경의 대표성을 갖는 것은 아니다.
따라서 한국어 교수 학습에서 /ㅓ/를 원순 모음으로 재분류할 필요는 없지만 음운론적 평순성과 실제 발화에서 나타나는 음향적 변이를 함께 제시할 필요는 있다. 특히 교수 학습에서 모음 제시 후 관련 어휘를 제시할 때 어두에 /ㅓ/가 배치되는 어휘 제시에 한정하지 않고, /ㅓ/가 어두와 비어두에 나타나는 다양한 음절 구조와 분절음 환경의 어휘를 함께 제시함으로써 학습자가 특정 환경의 /ㅓ/만을 대표적인 발음으로 학습하지 않도록 할 필요가 있다. 또한 /ㅓ/와 /ㅗ/의 최소대립쌍 어휘를 통해 /ㅓ/와 /ㅗ/의 입술 돌출 등을 비교하여 함께 제시할 수 있다. 이러한 교수 학습 방안은 /ㅓ/를 원순 모음으로 가르치기 위한 것이 아니며, /ㅓ/의 음운론적 평순성과 음성적 변이 가능성을 이해시키기 위한 것이다.
4. 결론
본 연구는 /ㅓ/의 원순성 여부와 정도를 논의하기 위해 음성적 지표인 F3Bark-F2Bark와 F2Bark, F3Bark를 분석하고 프랑스인 모어 화자를 대상으로 한 지각 실험을 수행했다. 음향 분석 결과 /ㅓ/가 전형적인 원순 모음의 음향적 특성은 아니지만 일부 지표에서 평순 모음보다 원순 모음에 가까운 음향적 양상을 보이고 있음이 확인되었다. 특히 F3Bark에서는 원순 모음과 유사한 양상이 관찰되었으나 F2Bark, F3Bark-F2Bark에서는 원순 모음과 구별되는 특성 또한 확인되었다. 따라서 /ㅓ/는 음운론적으로 평순 모음으로 분류되지만 음성적 실현에서는 원순 모음과 유사성을 보일 수 있는 모음으로 해석했다.
청지각 실험에서는 프랑스어 모어 화자가 한국어 단모음 /ㅓ/를 처음 지각할 때 모어의 원순 모음으로 범주화할 가능성이 상대적으로 높았다. 그러나 이들 선택지에 대한 모형 기반 예상 평정은 대체로 낮게 나타나 이를 /ㅓ/와 원순 모음 간 높은 유사성으로 해석하기보다는 /ㅓ/가 원순 모음 범주로 부분적 범주화할 가능성을 보여 주는 결과로 해석했다.
본 연구의 의의는 한국어 음운 체계에서 /ㅓ/를 평순 모음으로 분류하는 것과 실제 발화에서 나타나는 음향적 변이를 구분하여 논의했다는 데 있다. 또한 음향 분석에만 의존하지 않고 프랑스어 모어 화자의 청지각 자료를 함께 검토함으로써 /ㅓ/가 가진 부분적 원순 모음과의 유사성이 비모어 청자의 모음 범주화에 영향을 끼칠 가능성을 제기했다. 이는 한국어 교육에서 /ㅓ/를 원순 모음으로 재분류해야 한다는 의미는 아니며, /ㅓ/의 음운론적 평순성과 실제 발화에서 나타나는 음향적 변이를 함께 고려하여 다양한 음성 자료를 제시해야 할 필요성을 시사한다.
다만 표본의 인구통계학적 제한과 청지각 실험이 모어에 후설 평순 중모음 범주가 없는 프랑스인 모어 화자에 한정되었다는 한계가 있다. 또한 실제 한국어 학습자의 지각, 산출 능력이나 교수 학습 효과에 대한 검증이 필요하다. 이에 후속 연구에서는 다양한 환경의 한국어 화자와 언어권의 청자를 포함하고, 입술 원순화와 혀의 위치를 직접 측정하는 조음 분석, /ㅓ/-/ㅗ/의 지각 산출 실험, 그리고 교수 학습 효과에 대한 검증이 이루어져야 할 것이다.

